
Tóm tắt
Duplicate content (nội dung trùng lặp) là những khối nội dung đáng kể giống hệt hoặc gần giống xuất hiện trên nhiều URL khác nhau. Theo các chuyên gia tại ClickOn Digital, việc hiểu rõ và xử lý nội dung trùng lặp là yếu tố quan trọng giúp website tránh bị tụt hạng, cải thiện trải nghiệm người dùng và tăng độ tin cậy với Google. Bài viết này sẽ giúp bạn hiểu rõ về “duplicate content là gì?“, tác động của nó đến SEO, và hướng dẫn chi tiết cách phát hiện và khắc phục hiệu quả.
1. Giới thiệu toàn diện về duplicate content
Google định nghĩa duplicate content không chỉ đơn thuần là “sao chép và dán” mà còn bao gồm cả những nội dung có sự tương đồng đáng kể, dù không hoàn toàn giống nhau. Điều này khiến công cụ tìm kiếm gặp khó khăn trong việc quyết định phiên bản nào cần ưu tiên hiển thị trong kết quả tìm kiếm.
Định nghĩa chính thức duplicate content là gì
Theo định nghĩa chính thức, duplicate content là gì? Đó là những khối nội dung đáng kể giống hệt hoặc gần giống nhau xuất hiện trên nhiều URL khác nhau. Tuy nhiên, cần lưu ý rằng không phải tất cả nội dung giống nhau đều bị xem là trùng lặp có hại.
Ví dụ, các phần nội dung “boilerplate” hợp pháp như footer, header, menu điều hướng, thông tin liên hệ… xuất hiện trên nhiều trang của cùng một website thì không bị xem là duplicate content có vấn đề.
Khi nói đến duplicate content, chúng ta thường đề cập đến những khối nội dung lớn như bài viết, mô tả sản phẩm, hoặc trang thông tin có nội dung rất giống nhau nhưng lại được đặt ở nhiều URL khác nhau, gây nhầm lẫn cho cả người dùng và công cụ tìm kiếm.
Phạm vi trùng lặp: nội bộ vs chéo miền
Dựa trên phạm vi xuất hiện, duplicate content có thể được chia thành hai loại chính:
1. Nội dung trùng lặp nội bộ (internal duplicate content): Xảy ra khi cùng một nội dung xuất hiện tại nhiều URL khác nhau trên cùng một tên miền. Ví dụ:
www.website.com/page1vàwww.website.com/page2có nội dung giống hệt nhauwww.website.com/san-phamvàwww.website.com/san-pham?sort=pricehiển thị cùng một danh sách sản phẩm
2. Nội dung trùng lặp chéo miền (cross-domain duplicate content): Xảy ra khi cùng một nội dung xuất hiện trên nhiều trang web khác nhau. Ví dụ:
website1.comvàwebsite2.comcó những bài viết giống hệt nhau- Mô tả sản phẩm được sao chép từ website của nhà sản xuất sang nhiều website bán lẻ khác
Việc phân biệt rõ hai loại này rất quan trọng vì chúng đòi hỏi những phương pháp xử lý khác nhau.
2. Các loại duplicate content cụ thể trong thực tế
Để hiểu rõ hơn về vấn đề duplicate content là gì, chúng ta cần phân loại cụ thể các trường hợp thường gặp trong thực tế. Dưới đây là một số hình thức phổ biến nhất của nội dung trùng lặp mà các website thường gặp phải.
Duplicate content do lỗi kỹ thuật website
Nhiều trường hợp duplicate content không phải do cố tình tạo ra mà xuất phát từ các vấn đề kỹ thuật của website:
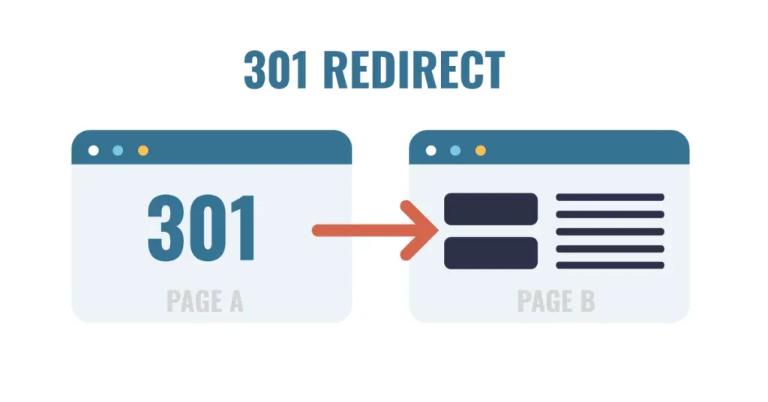
- www và non-www: Khi website không thiết lập chuyển hướng giữa phiên bản
wwwvànon-www, Google sẽ coiwww.example.comvàexample.comlà hai trang khác nhau dù chúng hiển thị cùng nội dung. - HTTP và HTTPS: Tương tự, nếu không có chuyển hướng 301 từ HTTP sang HTTPS, cả hai phiên bản đều có thể được lập chỉ mục và tạo ra nội dung trùng lặp.
- Tham số URL (URL parameters): Các tham số như
?utm_source=abc,?sessionid=123,?sort=pricecó thể tạo ra nhiều URL khác nhau nhưng dẫn đến cùng nội dung.
Ví dụ thực tế: Một cửa hàng trực tuyến có thể có cùng một danh sách sản phẩm được hiển thị tại:
example.com/dien-thoaiexample.com/dien-thoai?sort=price-ascexample.com/dien-thoai?filter=brand:samsungexample.com/dien-thoai?page=1
Tất cả các URL này có thể chứa nội dung tương tự nhau nhưng được Google xem là các trang riêng biệt.
Duplicate content do quản trị nội dung sử dụng
Một số trường hợp duplicate content phát sinh do cách quản trị nội dung:
- Sao chép nguyên văn từ website khác: Việc copy nguyên xi nội dung từ trang khác về website của mình là hình thức duplicate content phổ biến nhất.
- Viết lại/Diễn giải (Rewrite/Paraphrase): Khi viết lại nội dung từ nguồn khác nhưng vẫn giữ nguyên cấu trúc ý chính, dù từ ngữ có khác nhưng Google vẫn có thể nhận diện được sự tương đồng.
- Đăng tải trên nhiều nền tảng: Nhiều người thường đăng tải cùng một bài viết lên blog cá nhân, Medium, LinkedIn và các nền tảng khác mà không có sự điều chỉnh hoặc chỉ định phiên bản gốc.
Duplicate content hợp pháp (boilerplate & chuẩn)
Không phải tất cả nội dung trùng lặp đều có hại. Một số loại nội dung trùng lặp được xem là hợp pháp:
- Nội dung boilerplate hợp pháp: Các trang Điều khoản dịch vụ, Chính sách bảo mật, chân trang (footer) xuất hiện trên hầu hết các trang của website.
- Mô tả sản phẩm từ nhà cung cấp: Các cửa hàng trực tuyến thường sử dụng mô tả sản phẩm do chính nhà sản xuất cung cấp.
- Thông số kỹ thuật và tài liệu hướng dẫn: Những thông tin này thường giống nhau trên nhiều website bán cùng một sản phẩm.
3. Cơ chế Google phát hiện và xử lý duplicate content
Để hiểu rõ tác động của duplicate content là gì đối với SEO, cần nắm được cách Google phát hiện và xử lý vấn đề này.

Checksum và thuật toán phân loại nội dung
Google sử dụng nhiều phương pháp để phát hiện nội dung trùng lặp:
- Checksum: Đây là biểu diễn số học của nội dung (thông qua hàm băm/hash). Khi hai trang có nội dung giống nhau, giá trị checksum của chúng sẽ tương đồng.
- Thuật toán học máy (Machine learning): Google còn sử dụng các thuật toán học máy tiên tiến để phát hiện nội dung “đáng kể tương tự” (appreciably similar), kể cả khi chúng không hoàn toàn giống nhau.
Quá trình này diễn ra tự động và liên tục trong quá trình Google thu thập và lập chỉ mục nội dung web.
Quy trình Google chọn canonical version
Khi phát hiện nội dung trùng lặp, Google sẽ thực hiện các bước sau:
- Crawl nhiều URL có nội dung giống nhau
- Phân tích các tín hiệu để xác định “phiên bản ưu tiên” (preferred version)
- Chọn một URL để lập chỉ mục và xếp hạng, ẩn các URL khác khỏi kết quả tìm kiếm
Các yếu tố ảnh hưởng đến việc chọn phiên bản canonical:
- URL nào được chỉ định trong thẻ canonical
- URL nào được sử dụng trong sitemap
- URL nào có chất lượng và số lượng backlink tốt hơn
- URL nào đơn giản và dễ đọc hơn
- Giao thức (HTTPS thường được ưu tiên hơn HTTP)
Grouped duplicates và impact lên rankings
Khi Google phát hiện các trang trùng lặp, nó thực hiện quá trình “gom nhóm duplicates”:
- Các URL có nội dung tương tự được nhóm lại
- Chỉ một phiên bản được chọn để hiển thị trong kết quả tìm kiếm
- Các tín hiệu xếp hạng (backlink, tín hiệu người dùng) từ tất cả các phiên bản được tổng hợp cho phiên bản được chọn
Tuy nhiên, quá trình này cũng gây ra nhiều vấn đề:
- Backlink dilution: Các liên kết đến từ các URL khác nhau không được tích lũy hoàn toàn
- Lãng phí ngân sách thu thập (crawl budget): Google phải dành tài nguyên để thu thập nhiều URL với cùng nội dung
- Sự không nhất quán: Google có thể chọn phiên bản bạn không mong muốn làm phiên bản chính
Bảng so sánh tác động của duplicate content:
| Tiêu chí | Trang có nội dung độc đáo | Trang có nội dung trùng lặp |
|---|---|---|
| Tỷ lệ được lập chỉ mục | Cao | Thấp |
| Thứ hạng từ khóa | Ổn định | Không ổn định |
| Giá trị backlink | Tích tụ đầy đủ | Bị phân tán |
| Crawl budget | Sử dụng hiệu quả | Lãng phí |
| Traffic | Tối ưu | Giảm |
4. Tại sao Google quan tâm về duplicate content?
Nhiều người thắc mắc duplicate content là gì mà Google phải quan tâm đến vậy? Câu trả lời nằm ở trải nghiệm người dùng và mục tiêu chất lượng của Google.
Ảnh hưởng đến trải nghiệm người dùng (UX)
Nội dung trùng lặp tạo ra trải nghiệm tìm kiếm kém chất lượng. Hãy tưởng tượng:
- Người dùng tìm kiếm “các kỹ thuật SEO 2025” và 5 kết quả đầu tiên trong SERP có 3 kết quả với nội dung gần như giống hệt nhau, chỉ khác tên miền.
- Người dùng bấm vào trang thứ hai, thấy nội dung giống trang thứ nhất, tiếp tục bấm vào trang thứ ba và cũng thấy nội dung tương tự.
- Điều này gây lãng phí thời gian và tạo trải nghiệm tìm kiếm kém chất lượng.
Google luôn muốn cung cấp kết quả đa dạng và có giá trị, vì vậy nội dung trùng lặp là một trở ngại lớn.
Thách thức cho Google index và ranking
Duplicate content gây ra nhiều thách thức cho Google:
- Hiệu quả lập chỉ mục: Google phải sử dụng tài nguyên để lập chỉ mục nhiều phiên bản của cùng một nội dung.
- Khó xác định bản gốc: Khi nhiều trang có nội dung giống nhau, Google phải tự quyết định phiên bản nào là gốc, đôi khi quyết định này không đúng với ý định của chủ website.
- Phân tán giá trị uy tín (Authority dilution): Các tín hiệu xếp hạng như backlink bị phân tán giữa nhiều URL thay vì tập trung vào một trang.
Phòng chống spam & thao túng ranking
Nếu Google không xử lý duplicate content, các website có thể dễ dàng spam kết quả tìm kiếm:
- Tạo hàng trăm trang với nội dung giống nhau nhưng URL khác nhau
- Sao chép nội dung từ website uy tín và cố gắng xếp hạng với nội dung đó
- Tạo nhiều trang con với nội dung gần như giống nhau
Cách Google xử lý: Nhóm các nội dung trùng lặp, chỉ xếp hạng một phiên bản, từ đó ngăn chặn chiến thuật spam này.
5. Phân biệt duplicate content penalty là thật hay hư cấu?
Một trong những hiểu lầm phổ biến về duplicate content là gì? Đó chính là niềm tin rằng Google có “hình phạt duplicate content” chính thức. Sự thực có đôi chút khác biệt.
Không có “duplicate content penalty” chính thức
Theo thông tin chính thức từ Google:
- Google KHÔNG tự động “phạt” website chỉ vì có nội dung trùng lặp
- Matt Cutts (cựu kỹ sư cấp cao của Google) từng nói “khoảng 26-30% Internet là nội dung trùng lặp – không thể phạt tất cả”
- Thay vì phạt, Google tập trung vào việc lọc và chọn phiên bản tốt nhất để hiển thị
Vì vậy, nếu website của bạn vô tình có một số trang với nội dung tương tự, bạn không cần lo lắng về việc bị “phạt” một cách tự động.
Khi nào Google xử lý duplicate content
Tuy nhiên, Google sẽ có biện pháp xử lý trong những trường hợp sau:
- Duplicate content cố ý để thao túng xếp hạng: Tạo nhiều phiên bản của cùng nội dung để chiếm nhiều vị trí trong kết quả tìm kiếm.
- Nội dung lấy từ website khác (external duplicate): Sao chép nội dung từ các trang web khác mà không thêm giá trị.
- Phân phối nội dung không có thẻ canonical: Đăng tải cùng một nội dung trên nhiều trang web khác nhau mà không chỉ định phiên bản gốc.
Khi nào không bị phạt
Một số trường hợp duplicate content thường không gây vấn đề:
- Trang thử nghiệm (Staging sites): Các phiên bản phát triển của website, miễn là chúng được bảo vệ khỏi công cụ tìm kiếm.
- Nội dung boilerplate: Các phần nội dung tiêu chuẩn xuất hiện trên nhiều trang như footer, header.
- Phiên bản in (Print-friendly versions): Các phiên bản trang web được thiết kế để in ấn.
6. Nguyên nhân gây duplicate content – phân loại chi tiết
Để hiểu rõ hơn duplicate content là gì và làm thế nào để ngăn ngừa, cần nắm được các nguyên nhân phổ biến gây ra vấn đề này.
Nguyên nhân kỹ thuật không ý muốn
Nhiều trường hợp duplicate content xuất phát từ các vấn đề kỹ thuật mà chủ website không cố ý tạo ra:
- Biến thể giao thức & tên miền phụ: URL có thể truy cập qua nhiều cách như
https://example.com,http://example.com,https://www.example.com,http://www.example.com. - Tham số URL: Các tham số như
?utm_source=,?sessionid=,?sort=,?filter=tạo ra nhiều URL khác nhau nhưng dẫn đến cùng nội dung. - Hiển thị theo thiết bị: Phiên bản di động và máy tính để bàn có thể tạo ra URL khác nhau nhưng nội dung tương tự.
Nguyên nhân chiến lược / nội dung
Một số nguyên nhân liên quan đến chiến lược nội dung:
- Phân phối nội dung không có canonical: Đăng tải cùng một bài viết trên blog cá nhân, Medium, LinkedIn mà không sử dụng thẻ canonical.
- Viết lại & Diễn giải: Viết lại nội dung từ nguồn khác nhưng vẫn giữ cấu trúc và ý tưởng tương tự.
- Mô tả sản phẩm thương mại điện tử: Sử dụng mô tả sản phẩm từ nhà cung cấp mà không chỉnh sửa hoặc bổ sung nội dung độc đáo.
Nguyên nhân do công cụ & plugin
Các công cụ và plugin cũng có thể gây ra duplicate content:
- Giao diện WordPress: Một số giao diện tự động tạo ra nhiều phiên bản của cùng nội dung.
- Vấn đề nền tảng thương mại điện tử: Nhiều nền tảng tạo ra URL khác nhau cho cùng một sản phẩm khi nó thuộc nhiều danh mục.
- Chuyển hướng hỏng: Chuyển hướng không hoạt động đúng có thể khiến cả URL gốc và URL đích đều được lập chỉ mục.
7. Cách phát hiện duplicate content – công cụ & phương pháp
Để giải quyết vấn đề, trước tiên cần phát hiện duplicate content là gì và nó đang tồn tại ở đâu trên website của bạn.
Kiểm tra thủ công bằng search operators
Bạn có thể sử dụng một số toán tử tìm kiếm của Google để kiểm tra nội dung trùng lặp:
1. Sử dụng toán tử `site:` để xem trang nào của website đã được Google lập chỉ mục:
```
site:example.com
```
2. Kết hợp với một đoạn nội dung cụ thể để tìm các trang có nội dung tương tự:
```
site:example.com "đoạn nội dung cụ thể"
```
3. Tìm kiếm đoạn nội dung không giới hạn trong trang web của bạn để phát hiện sao chép từ các nguồn khác:
```
"đoạn nội dung cụ thể từ website của bạn"
```
Google Search Console duplicate report
Google Search Console cung cấp báo cáo về các vấn đề liên quan đến nội dung trùng lặp:
- “Duplicate, without user-selected canonical“: Những trang có nội dung trùng lặp mà bạn chưa chỉ định phiên bản canonical.
- “Duplicate, Google chose different canonical“: Google đã chọn một phiên bản canonical khác với phiên bản bạn đã chỉ định.
- “Excluded because of alternate page“: Trang bị loại trừ vì Google coi nó là phiên bản thay thế của một trang khác.
Những báo cáo này giúp bạn nhanh chóng xác định những trang cần được xử lý.
Công cụ kiểm tra tự động – so sánh & khuyến nghị
Ngoài các phương pháp trên, bạn có thể sử dụng các công cụ chuyên dụng:
- SEMrush: Công cụ này có tính năng kiểm tra nội dung trùng lặp và gợi ý cách khắc phục.
- Screaming Frog: Phần mềm này có thể quét toàn bộ website và phát hiện các trang có tiêu đề và mô tả giống nhau, thường là dấu hiệu của duplicate content.
- Copyscape: Công cụ chuyên dụng để kiểm tra nội dung sao chép giữa các website khác nhau.
8. Chiến lược khắc phục duplicate content
Sau khi hiểu rõ duplicate content là gì và phát hiện các vấn đề trên website, đây là những chiến lược hiệu quả để khắc phục.

Canonical tag – giải pháp cho kỹ thuật duplicates
Thẻ canonical là một trong những giải pháp hiệu quả nhất:
```html
<link rel="canonical" href="https://example.com/trang-chinh/" />
```
Cách hoạt động: Bạn chỉ định URL ưu tiên, Google sẽ hiểu rằng đó là phiên bản bạn muốn được lập chỉ mục và xếp hạng.
Ứng dụng thực tế:
- Sử dụng cho các trang sản phẩm xuất hiện trong nhiều danh mục
- Sử dụng cho các URL có tham số khác nhau
- Sử dụng khi xuất bản nội dung trên nhiều nền tảng khác nhau
Noindex tag – ẩn pages khỏi indexing
Thẻ noindex giúp ngăn Google lập chỉ mục một trang cụ thể:
```html
<meta name="robots" content="noindex" />
```
Cách hoạt động: Google vẫn crawl trang, nhưng khi thấy thẻ noindex, nó sẽ không đưa trang vào chỉ mục tìm kiếm.
Ứng dụng thực tế:
- Các trang lọc hoặc sắp xếp trong thương mại điện tử
- Các phiên bản in của trang
- Các trang tạm thời hoặc thử nghiệm
301 redirect – chuyển hướng & merge rankings
Chuyển hướng 301 là giải pháp vĩnh viễn để hợp nhất nhiều URL thành một:
Cách hoạt động: Khi người dùng truy cập URL cũ, server sẽ tự động chuyển hướng họ đến URL mới với mã trạng thái HTTP 301 (đã chuyển vĩnh viễn).
Ứng dụng thực tế:
- Hợp nhất phiên bản
wwwvànon-www - Chuyển từ HTTP sang HTTPS
- Thay đổi cấu trúc URL của website
Remove completely – xóa pages không cần thiết
Trong một số trường hợp, cách tốt nhất là xóa hoàn toàn nội dung trùng lặp:
Ứng dụng thực tế:
- Các trang không có giá trị đối với người dùng
- Các trang backup cũ (
.old,.bak) - Nội dung lỗi thời hoặc không chính xác
Rewrite & add value – tăng unique content
Viết lại và bổ sung giá trị là cách tốt nhất để chuyển nội dung trùng lặp thành nội dung độc đáo:
Ứng dụng thực tế:
- Nội dung được syndicate (đăng lại) từ các nguồn khác
- Mô tả sản phẩm từ nhà cung cấp
- Nội dung marketing từ nhiều nguồn
Xem thêm:
Kết luận – khai hóa sức mạnh của unique content
Duplicate content là gì? Qua bài viết này, chúng ta đã hiểu rằng nó không đơn thuần là vấn đề sao chép nội dung, mà còn liên quan đến nhiều khía cạnh kỹ thuật và quản trị nội dung.
Bằng cách áp dụng các chiến lược như sử dụng thẻ canonical, chuyển hướng 301, hoặc viết lại nội dung để tăng tính độc đáo, bạn có thể giải quyết vấn đề duplicate content và cải thiện thứ hạng tìm kiếm.
Google ưu tiên và khen thưởng nội dung gốc, có giá trị độc đáo. Đầu tư vào việc tạo nội dung chất lượng, độc đáo không chỉ giúp tránh các vấn đề về duplicate content mà còn xây dựng uy tín và thứ hạng bền vững cho website của bạn.
Tại ClickOn Digital, chúng tôi cung cấp dịch vụ toàn diện để kiểm tra, phát hiện và xử lý nội dung trùng lặp, tối ưu SEO on-page, kết hợp tạo backlink chất lượng, giúp website của bạn lên top bền vững và tăng hiệu quả marketing.
Q&A
Duplicate content có thực sự ảnh hưởng đến SEO không?
Có, duplicate content ảnh hưởng đến SEO theo nhiều cách. Google phải lựa chọn phiên bản nào để hiển thị trong kết quả tìm kiếm, điều này có thể dẫn đến việc trang quan trọng nhất của bạn không được chọn. Ngoài ra, giá trị liên kết bị phân tán giữa các phiên bản, làm giảm sức mạnh xếp hạng tổng thể.
Nếu tôi thêm canonical tag, Google có chắc chắn sẽ follow không?
Không, canonical tag chỉ là gợi ý cho Google. Trong hầu hết các trường hợp, Google sẽ tôn trọng canonical tag, nhưng trong một số trường hợp, nó có thể chọn một URL khác nếu thấy phù hợp hơn. Điều quan trọng là cần triển khai canonical tag một cách nhất quán và đảm bảo các tín hiệu khác (như liên kết nội bộ và sitemap) cũng trỏ đến URL canonical.
Có phải tất cả duplicate content đều hại không?
Không, một số loại duplicate content là bình thường và không gây hại, như các phần boilerplate (footer, header), các trang pháp lý (điều khoản sử dụng, chính sách bảo mật), hoặc các thông số kỹ thuật sản phẩm từ nhà sản xuất. Google khá thông minh trong việc hiểu và xử lý các loại nội dung trùng lặp này.


