

Tóm tắt
Index bloat là gì và vì sao một website chỉ có số ít trang hữu ích lại có lượng URL lớn gấp nhiều lần nằm trong chỉ mục của Google? Đây là tình trạng chỉ mục chứa quá nhiều URL không cần thiết, thường đến từ bộ lọc, trang tìm kiếm nội bộ, thẻ mỏng hoặc môi trường thử nghiệm. Khác với trùng lặp nội dung, vấn đề ở đây là URL không đáng có mặt, chứ chưa chắc nội dung giống nhau. ClickOn Digital sẽ phân biệt hai khái niệm và chỉ ra khi nào nên dùng canonical, noindex, chuyển hướng 301, robots.txt hay xóa nội dung.
Index bloat là gì?
Chỉ mục (index) là cơ sở dữ liệu nơi Google lưu thông tin các trang sau khi thu thập và phân tích. Index bloat là tình trạng chỉ mục chứa nhiều URL mà website không cần hoặc không muốn xuất hiện trên tìm kiếm, như trang lọc, kết quả tìm kiếm nội bộ, thẻ mỏng hoặc bản thử nghiệm.
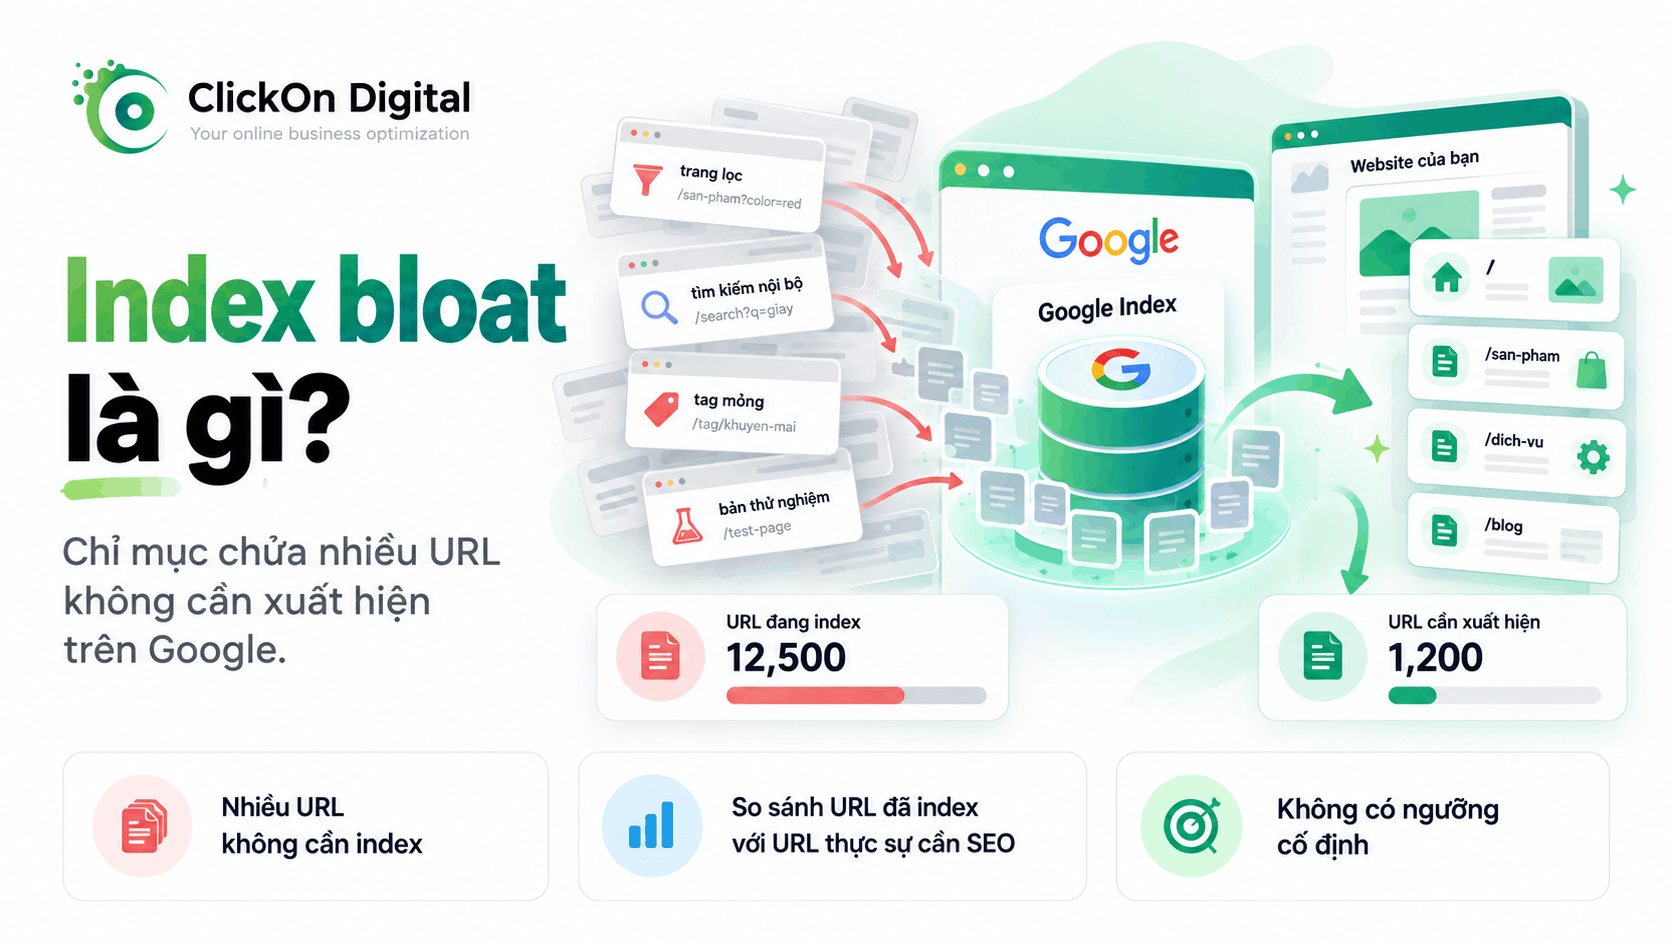
Đây là cách gọi quen thuộc trong cộng đồng SEO, không phải thuật ngữ xuất hiện trong các tài liệu Google đã đối chiếu. Vì vậy, kết luận website bị index bloat là đánh giá theo mục tiêu kinh doanh, không phải cảnh báo có sẵn trong công cụ.
Không có ngưỡng cố định cho “quá nhiều”. Hãy so số URL đang được lập chỉ mục với số trang bạn thực sự muốn xuất hiện trên Google, vì cùng một con số có thể bình thường với website thương mại điện tử lớn nhưng bất thường với website giới thiệu dịch vụ.
Index bloat ảnh hưởng thế nào đến thu thập dữ liệu và lập chỉ mục?
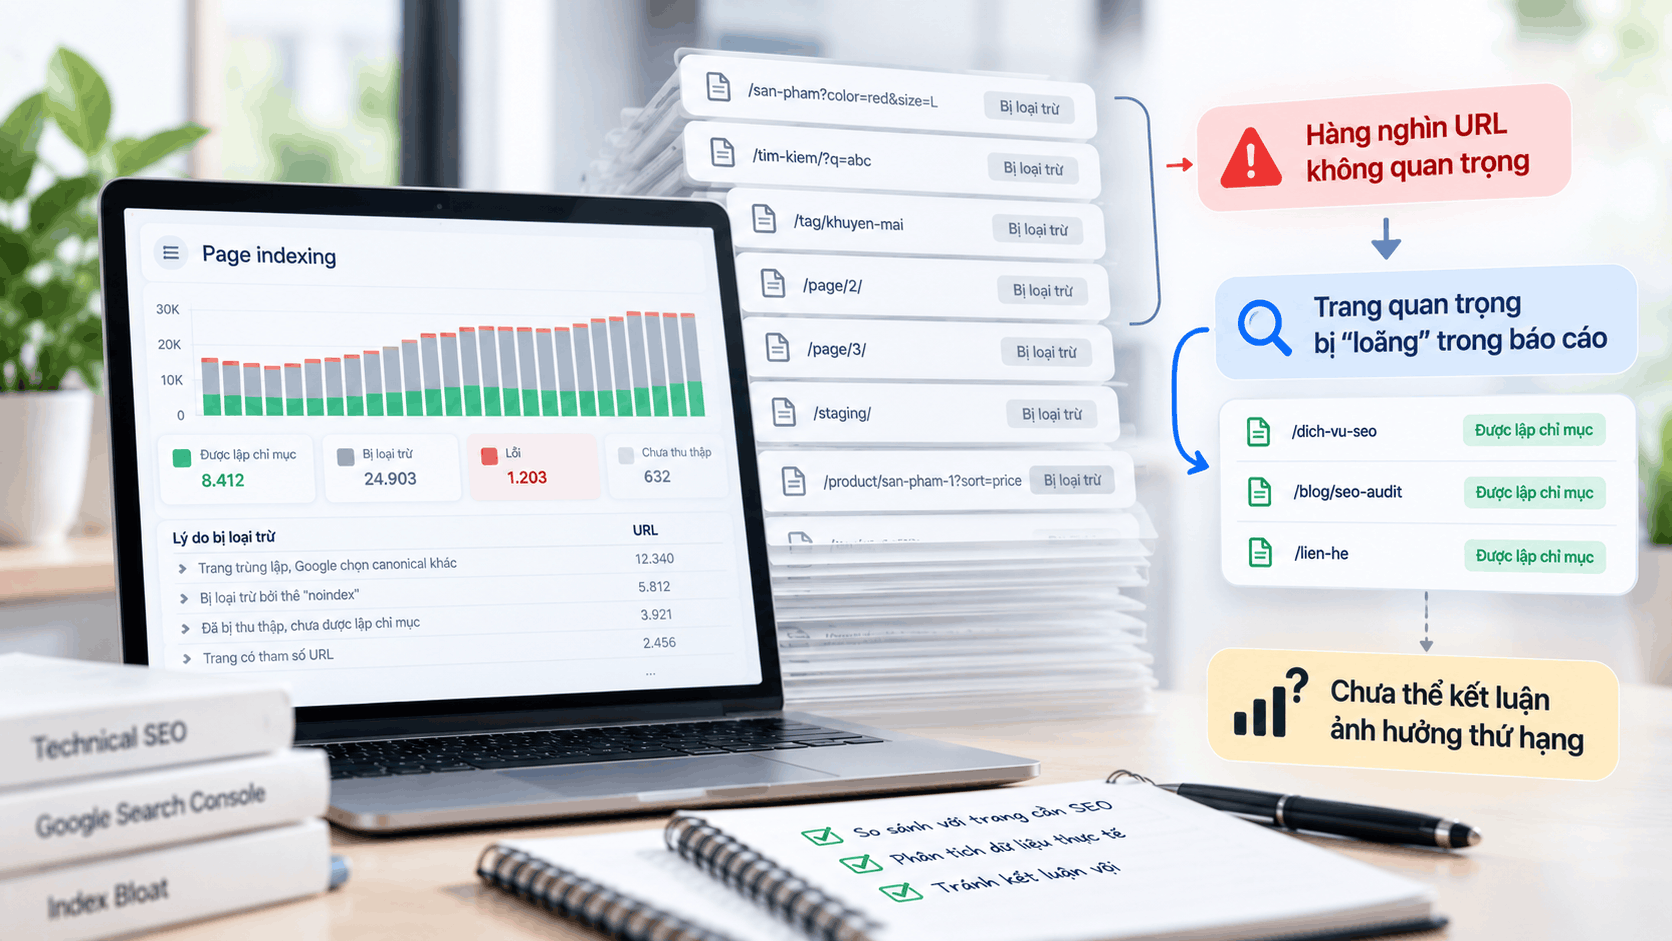
Ảnh hưởng chủ yếu là gián tiếp: thời gian của bot bị chia cho URL vô ích và báo cáo lập chỉ mục trở nên khó đọc.
Bot tốn thời gian vào URL không có giá trị
Theo hướng dẫn về điều hướng theo bộ lọc, URL tham số có thể tạo ra không gian URL gần như vô hạn. Bot thường truy cập rất nhiều URL mới xác định được chúng vô ích, khiến việc phát hiện nội dung mới chậm hơn. Hướng dẫn về crawl budget cũng nêu thời gian thu thập bị lãng phí khi nhiều URL không cần thu thập.
Google lưu ý hướng dẫn này chủ yếu dành cho website rất lớn, khoảng 1 triệu URL hoặc khoảng 10.000 URL với nội dung đổi hằng ngày. Đây chỉ là ước lượng, nên với website nhỏ, tác động lên tốc độ thu thập thường không đáng kể.
Báo cáo khó đọc, chưa thể kết luận ảnh hưởng thứ hạng
Khi hàng nghìn URL không quan trọng lẫn vào báo cáo Page indexing, trang cần SEO bị loại khỏi chỉ mục sẽ khó nhận ra hơn. Các tài liệu Google đã đối chiếu không cho phép kết luận nhiều URL trong chỉ mục trực tiếp kéo thứ hạng đi xuống, và traffic giảm cùng lúc số URL tăng cũng chưa chứng minh quan hệ nhân quả.
Index bloat và trùng lặp nội dung khác nhau thế nào?
Hai khái niệm hay bị gộp làm một nhưng trả lời hai câu hỏi khác nhau. Bảng dưới đây so sánh nhanh trước khi đi vào từng tình huống:
| Tiêu chí | Index bloat | Trùng lặp nội dung |
| Bản chất | Quá nhiều URL không cần thiết nằm trong chỉ mục | Nội dung giống hoặc rất giống nhau trên nhiều URL |
| Câu hỏi cần trả lời | URL này có đáng nằm trong chỉ mục không? | Các URL này có cùng thể hiện một nội dung không? |
| Ví dụ | Trang tìm kiếm nội bộ, thẻ mỏng, bản staging | Một sản phẩm có nhiều URL, biến thể http và https |
| Hướng xử lý chính | Ngăn lập chỉ mục hoặc loại bỏ URL không cần | Hợp nhất về một URL ưu tiên bằng 301 hoặc canonical |
Hai vấn đề có thể chồng lên nhau: một URL bộ lọc vừa gần giống trang gốc, vừa là URL thừa. Tuy vậy, theo cách Google Search hoạt động, Google gom nhóm các trang tương tự và chọn một trang đại diện, nên bản trùng chưa chắc nằm trong chỉ mục như một trang độc lập.
Ngược lại, trang tìm kiếm nội bộ hay bản staging không giống trang nào vẫn có thể là URL thừa. Với trùng lặp nội dung, ưu tiên hợp nhất; với URL thừa, ưu tiên ngăn lập chỉ mục hoặc loại bỏ.
Mỗi công cụ xử lý được gì và không làm được gì?
Mỗi công cụ có giới hạn riêng, theo tài liệu Google:
- Canonical: tín hiệu đề xuất URL ưu tiên, không phải lệnh bắt buộc.
- Chuyển hướng 301: tín hiệu mạnh, dùng khi muốn bỏ hẳn bản trùng; đích đến phải có nội dung tương đương.
- Noindex: loại trang khỏi kết quả, nhưng bot phải truy cập được trang mới đọc được chỉ thị. Noindex không giúp tiết kiệm thu thập và không dùng để chọn canonical.
- Robots.txt: ngăn bot vào nhóm URL, không phải cách ẩn trang. URL bị chặn vẫn có thể được lập chỉ mục mà không có nội dung nếu nơi khác liên kết đến.
- 404 hoặc 410: cho trang đã bỏ và không có trang thay thế.
Robots.txt và noindex không dùng chồng lên nhau trên cùng URL, vì bot bị chặn sẽ không đọc được thẻ noindex. Với URL đã nằm trong chỉ mục, trình tự thận trọng là noindex trước, chờ Google thu thập lại, rồi mới cân nhắc chặn thu thập. Đây là cách áp dụng nguyên tắc trên, không phải quy trình Google quy định.
Kiểm tra index bloat bắt đầu từ đâu?
Bắt đầu bằng danh sách trang bạn thực sự muốn có trên Google, thường lấy từ sitemap hoặc hệ quản trị nội dung. Sau đó thực hiện ba việc:
- So số trang đã lập chỉ mục trong báo cáo Page indexing với danh sách mục tiêu.
- Crawl website và nhóm URL theo mẫu: tham số, thư mục, loại trang, tên miền phụ.
- Kiểm tra vài URL đại diện của mỗi nhóm bằng URL Inspection để xem canonical Google chọn.
Nhiều URL “chưa lập chỉ mục” là chủ đích hợp lệ, nên cần phân loại trước khi sửa.
7 tình huống index bloat thường gặp và cách xử lý
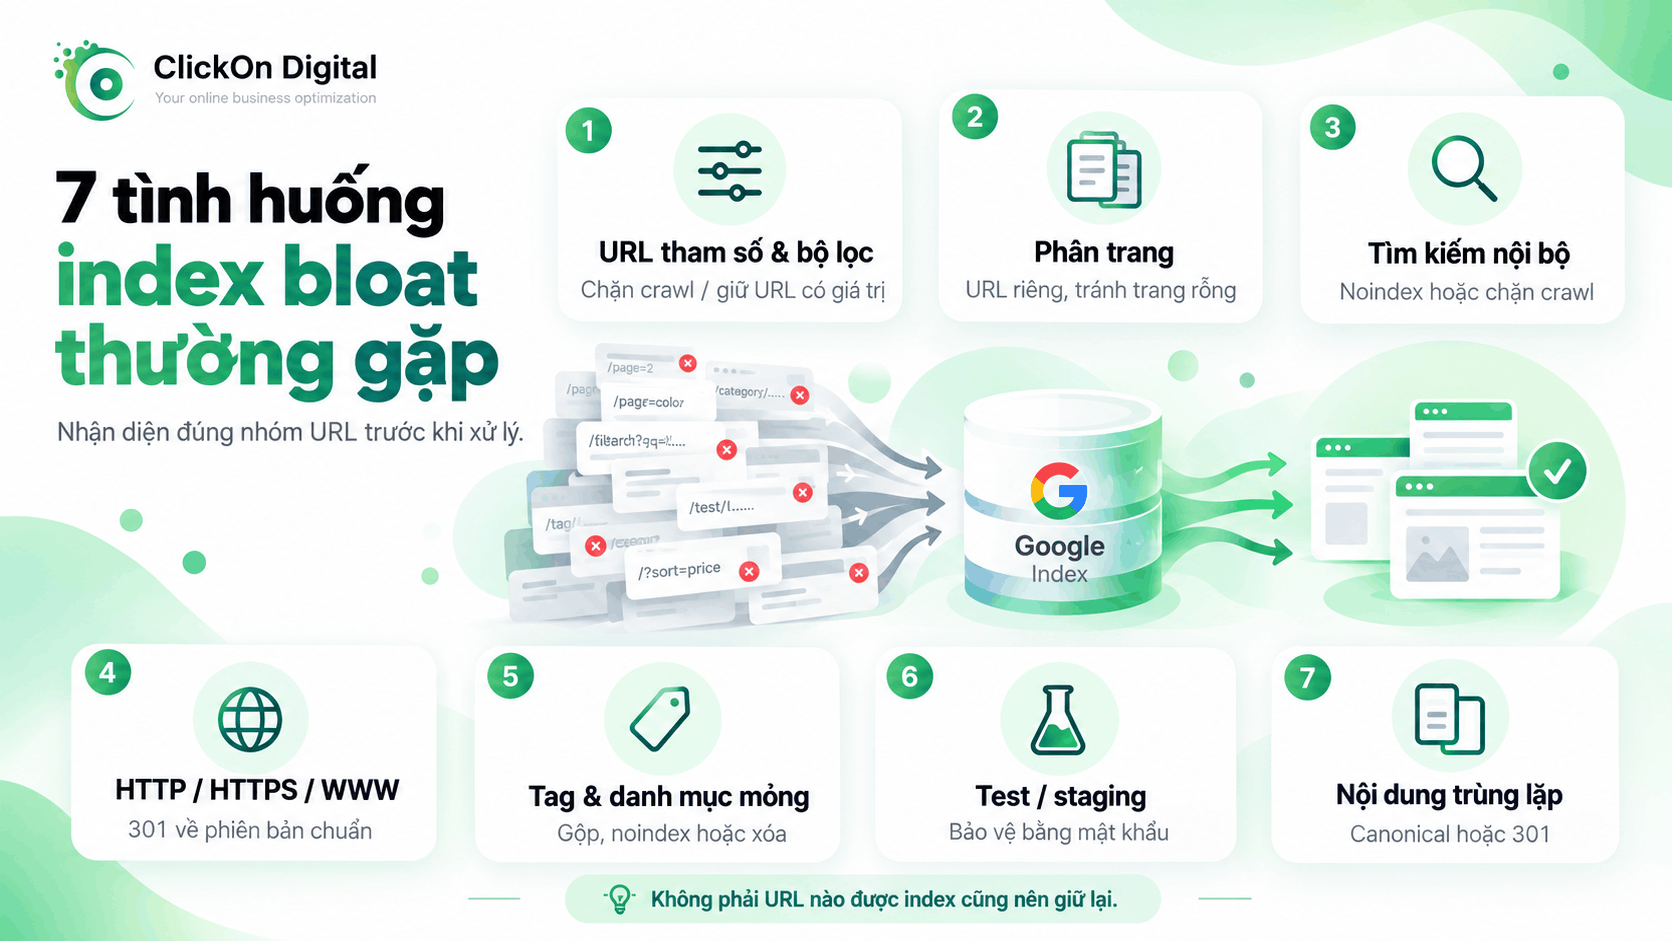
1. URL tham số và bộ lọc
Dấu hiệu: số URL chứa ?color=, ?size= hay ?sort= tăng mạnh khi thêm bộ lọc trong khi số sản phẩm gần như không đổi. Nguyên nhân: các tổ hợp lọc tạo ra không gian URL gần như không giới hạn. Kiểm tra: crawl, nhóm URL theo tham số, đối chiếu với Page indexing.
Xử lý: nếu tổ hợp lọc không có nhu cầu tìm kiếm riêng, Google khuyến nghị chặn thu thập bằng robots.txt; canonical hoặc nofollow được mô tả là kém hiệu quả hơn về lâu dài. Nếu một số tổ hợp đáng được lập chỉ mục, hãy giữ URL ổn định và trả 404 khi bộ lọc không có kết quả, thay vì trả 200 với trang trống, vì đó là dạng soft 404.
2. Phân trang
Phân trang không tự động là index bloat. Theo hướng dẫn phân trang của Google, mỗi trang nên có URL riêng, liên kết tuần tự bằng thẻ <a href> và không dùng trang 1 làm canonical cho cả chuỗi. Google cũng không còn dùng thẻ rel="next" và rel="prev".
Dấu hiệu cần xử lý: số trang vượt quá dữ liệu, trang trống, hoặc phân trang kết hợp bộ lọc và sắp xếp. Kiểm tra: thử số trang lớn hơn trang cuối; trang không tồn tại nên trả 404. Với biến thể sắp xếp hoặc lọc của cùng danh sách, Google gợi ý noindex hoặc robots.txt.
3. Trang tìm kiếm nội bộ
Dấu hiệu: URL dạng /?s=tu-khoa xuất hiện trong dữ liệu crawl hoặc báo cáo lập chỉ mục, kể cả cụm từ vô nghĩa. Nguyên nhân: mỗi từ khóa người dùng hoặc bot nhập sinh ra một URL mới. Kiểm tra: lọc URL theo tham số tìm kiếm trong dữ liệu crawl và Search Console.
Các tài liệu Google đã đối chiếu không có mục riêng cho loại trang này, nên hướng xử lý dựa trên nguyên tắc chung: nếu không cần xuất hiện trên Google, chặn thu thập bằng robots.txt; nếu đã bị lập chỉ mục, noindex trước, chặn thu thập sau. Không nên chủ động tạo hàng loạt trang giống kết quả tìm kiếm để xếp hạng, vì chính sách spam của Google xếp kiểu trang này vào nhóm lạm dụng trang dẫn.
4. Phiên bản http, https, www và non-www
Dấu hiệu: cùng một trang truy cập được qua nhiều địa chỉ và đều trả 200. Nguyên nhân: cấu hình máy chủ hoặc chuyển hướng chưa hoàn chỉnh. Kiểm tra: mở cả bốn biến thể, dùng URL Inspection xem canonical Google chọn.
Xử lý: chọn một phiên bản làm URL ưu tiên và chuyển hướng 301 từ các biến thể còn lại; Google mô tả redirect là tín hiệu mạnh, redirect phía máy chủ cho hiệu quả nhanh nhất. Bổ sung canonical tự tham chiếu bằng URL tuyệt đối, để liên kết nội bộ và sitemap dùng đúng phiên bản. Google ưu tiên HTTPS làm canonical, trừ khi có vấn đề, chẳng hạn chứng chỉ lỗi hoặc canonical trỏ về HTTP.
5. Trang thẻ và danh mục mỏng
Dấu hiệu: hàng trăm trang thẻ chỉ gắn với một hoặc hai bài, ít nội dung riêng và gần như không có lượt hiển thị. Nguyên nhân: hệ quản trị nội dung tự sinh URL cho mỗi thẻ. Kiểm tra: xuất danh sách theo loại trang, ghép với lượt hiển thị, lượt nhấp, backlink và liên kết nội bộ.
Không nên xóa chỉ vì lượt truy cập thấp. Tùy giá trị, có thể bổ sung nội dung giới thiệu, gộp vào danh mục chính bằng 301, giữ cho người dùng nhưng gắn noindex, hoặc xóa và trả 404 hay 410 khi không còn vai trò. Hãy phân biệt thin content thật sự với trang ngắn nhưng vẫn đáp ứng nhu cầu. Tạo hàng loạt trang giá trị thấp để xếp hạng có thể rơi vào nhóm lạm dụng nội dung quy mô lớn theo chính sách spam của Google.
6. Trang test và staging
Dấu hiệu: tên miền phụ như staging. hoặc dev. xuất hiện trong kết quả tìm kiếm hoặc báo cáo lập chỉ mục. Nguyên nhân: môi trường thử nghiệm công khai không có mật khẩu, hoặc noindex bị bỏ sót. Chiều ngược lại cũng cần kiểm tra: noindex từ staging có thể vô tình lên bản chính thức.
Xử lý: bảo vệ môi trường bằng mật khẩu, vì robots.txt không phải cơ chế ẩn trang. Nếu đã bị lập chỉ mục, dùng noindex hoặc gỡ trang hoàn toàn, rồi kiểm tra canonical và sitemap để chắc không trỏ về miền staging.
7. Nội dung trùng lặp thật sự
Dấu hiệu: cùng nội dung truy cập qua nhiều URL, như sản phẩm nằm trong nhiều danh mục, bài đăng lại hoặc URL có mã theo dõi. Page indexing có thể hiện “Duplicate without user-selected canonical”, mà theo Google không phải lỗi, hoặc “Duplicate, Google chose different canonical than user”, cần kiểm tra vì Google không đồng ý với URL bạn khai báo.
Kiểm tra: dùng URL Inspection so sánh canonical bạn khai báo với canonical Google chọn. Xử lý: muốn bỏ bản trùng thì dùng 301; bản trùng cần tồn tại thì dùng canonical trỏ về URL ưu tiên, kết hợp sitemap và liên kết nội bộ nhất quán.
Bảng chọn cách xử lý theo tình huống
Bảng tổng hợp dưới đây giúp đối chiếu nhanh trước khi giao việc cho đội kỹ thuật:
| Tình huống | Hướng ưu tiên | Cần tránh |
| Tham số và bộ lọc | Robots.txt cho tổ hợp không cần lập chỉ mục; trả 404 khi không có kết quả | Cho thu thập thoải mái rồi chỉ trông cậy vào canonical |
| Phân trang | URL riêng, liên kết bằng <a href>, canonical riêng cho từng trang |
Canonical về trang 1; dùng # cho số trang |
| Tìm kiếm nội bộ | Robots.txt; noindex trước nếu đã bị lập chỉ mục | Để sinh hàng loạt trang có thể lập chỉ mục |
| http, https, www | 301 kèm canonical tuyệt đối và sitemap đúng phiên bản | Để nhiều biến thể cùng trả 200 |
| Thẻ và danh mục mỏng | Bổ sung, gộp 301, noindex hoặc 404 và 410 theo giá trị | Xóa hàng loạt chỉ vì traffic thấp |
| Staging | Mật khẩu; noindex hoặc gỡ nếu đã bị lập chỉ mục | Chỉ dựa vào robots.txt |
| Trùng lặp thật sự | 301 hoặc canonical | Noindex hay robots.txt để chọn canonical |
Sau khi thay đổi, theo dõi Page indexing và kiểm tra lại các URL mẫu. Xác nhận sửa lỗi trong Search Console thường mất khoảng hai tuần, nên chưa kết luận hiệu quả sau vài ngày.
Kết luận
Tóm lại, index bloat là gì? Đó là tình trạng chỉ mục giữ nhiều URL không phục vụ mục tiêu tìm kiếm, còn trùng lặp nội dung là vấn đề nội dung giống nhau; hai vấn đề có thể chồng lên nhau nhưng cần công cụ xử lý khác nhau. Với website phát sinh nhiều URL từ bộ lọc, thẻ và môi trường thử nghiệm, ClickOn Digital có thể hỗ trợ rà soát trong phạm vi SEO Audit để phân nhóm URL và xác định nhóm cần giữ, gộp, chặn hay loại bỏ trước khi chỉnh cấu hình.


